쇼츠 영상은 어떻게 비슷한 주제로 묶일까?
쇼츠를 넘기다 보면 비슷한 결의 영상이 자연스럽게 이어질 때가 있습니다. 그런데 그 "비슷하다"는 판단은 대체 무엇을 기준으로 내려지는 걸까요?
"타블로가 출연한 팟캐스트 영상을 끝까지 본 유저에게, 다음으로 어떤 영상을 보여주면 좋을까?"
랭플릭스 쇼츠 탭 추천을 한 단계 더 개인화하면서 저희가 가장 먼저 붙든 질문이 이것이었습니다. 유저마다 다른 영상을 보여주려면 "이 유저는 어떤 종류의 영상을 좋아한다"고 말할 수 있어야 하고, 그러려면 그보다 먼저 영상을 종류별로 묶는 일이 필요합니다.
문제는 이 "종류"를 정의하는 것이 생각보다 까다롭다는 점입니다. 같은 채널이면 비슷한 영상일까요? 같은 태그가 붙어 있으면 비슷한 걸까요? 저희는 둘 다 충분하지 않다고 판단했고, 결국 영상의 내용 자체를 벡터로 바꿔서 묶는 쪽을 택했습니다.
안녕하세요! 세타원에서 랭플릭스 쇼츠 탭 추천 시스템을 함께 개발한 songtaesoo입니다.
오늘은 추천 시스템의 가장 아래층에 해당하는 콘텐츠 클러스터링 작업을 소개하려고 합니다.
이번 작업에서 저희는:
- 채널이나 태그 대신 제목·자막·시놉시스를 가중 평균한 임베딩으로 영상을 표현하고
- 유클리드 거리가 아닌 코사인 기준의 Spherical K-Means로 군집화해야 하는 이유를 확인했으며
- 클러스터를 하나만 주는 대신 Top-3를 가중치와 함께 주는 방식으로 설명력을 16% 개선했습니다.
"비슷한 영상"을 정의하는 세 가지 방법
영상을 종류별로 묶는 방법은 크게 세 가지를 놓고 검토했습니다.
- 채널로 묶기
가장 쉽고 직관적인 방법입니다. 같은 채널이면 비슷할 것이라고 가정하는 것입니다. 실제로 측정해보니 채널 단위 분류의 설명력은 R² 0.235 정도였습니다. 나쁘지 않은 출발점이지만, 한 채널이 여러 주제를 다루기도 하고 서로 다른 채널이 사실상 같은 이야기를 하기도 하니 한계가 분명했습니다. - 토픽 태그로 묶기
이미daily,entertainment,news같은 태그를 붙여두고 있었습니다. 다만 사람이 정의한 태그 체계는 개수가 고정되어 있고 경계를 딱 떨어지게 나누기 어렵습니다. 여러 성격이 섞인 영상을 하나의 태그로 표현하기에는 아무래도 정보가 부족했습니다. - 영상의 내용 자체로 묶기
결국 이 방법을 택했습니다. 사람이 미리 정한 칸에 영상을 끼워 넣는 대신, 영상들이 알아서 모이게 두는 방식입니다.
영상 1편을 벡터 1개로
영상에서 쓸 수 있는 텍스트는 제목, 자막, 시놉시스 세 가지였습니다. 셋을 이어 붙여 한 번에 임베딩하는 방법도 있지만, 그러면 수백 자짜리 자막이 열 자짜리 제목을 통째로 덮어버립니다. 그래서 필드별로 따로 임베딩한 뒤 가중 평균을 내기로 했습니다.
자막에 가장 큰 가중치인 0.5를 준 것은 영상이 실제로 무슨 이야기를 하는지가 결국 자막에 담겨 있기 때문이고, 시놉시스를 0.1로 낮춘 것은 원본 영상의 설명란에서 가져오는 정보라 구독 안내나 해시태그가 상당 부분을 차지하는 경우가 많았기 때문입니다.
예상 밖이었던 것은 채널명이었습니다. 채널명은 분명 강한 신호입니다. 그런데 콘텐츠 벡터에 섞는 순간 클러스터가 사실상 채널 목록이 되어버렸습니다. 그래서 콘텐츠 벡터에서는 제외하고 별도 피처로 분리해 관리했습니다.
전처리도 필드마다 다르게 적용했습니다. 제목은 손대지 않았고, 자막은 <br/> 태그를 공백으로 바꾼 뒤 괄호·음악기호·화자 표기를 정리했으며, 시놉시스는 URL·이메일·SNS 핸들·구독 안내 문구를 제거했습니다. 사소해 보이지만 이 정리 전후의 클러스터 품질 차이가 컸습니다.
왜 거리가 아니라 방향으로 묶었는가
여기서 한 번 제대로 막혔습니다. 일반 K-Means는 유클리드 거리로 묶습니다. 그런데 텍스트 임베딩에서 실제로 사용하는 유사도는 코사인 유사도, 즉 벡터의 방향입니다.
둘이 비슷해 보이지만 결과는 전혀 다릅니다. 세 필드를 가중 평균하고 나면 벡터 길이가 제각각이 되는데, 이 길이는 주제와 아무 상관이 없습니다. 오히려 세 필드가 서로 얼마나 일치했는지를 반영하는 값에 가깝습니다.
같은 타블로 영상이라도 자막이 길면 벡터가 길어집니다. 그래서 거리로 재면, 자막만 짧을 뿐 내용은 똑같은 영상보다 오히려 전혀 다른 주제의 뉴스 영상이 더 가깝게 나오는 일이 생깁니다. 게다가 서빙 단계에서는 코사인 유사도로 조회하게 되므로, 묶는 기준과 찾는 기준이 서로 어긋납니다.
그래서 평균 중심화 후 L2 정규화로 모든 벡터를 단위 구(sphere) 위에 올리고, 코사인 기준으로 군집화하는 Spherical K-Means를 사용했습니다. 이름은 거창하지만 구현은 단순합니다. 매 반복에서 centroid를 다시 L2 정규화해주기만 하면 됩니다.
X = normalize(X - X.mean(axis=0))          # 평균 중심화 → L2 정규화

for _ in range(max_iter):
    sims = X @ centroids.T                  # 정규화했으므로 내적 = 코사인 유사도
    labels = sims.argmax(axis=1)
    for k in range(K):
        centroids[k] = X[labels == k].mean(axis=0)
    centroids = normalize(centroids)        # 평균을 냈으니 다시 구 위로
K는 몇 개가 좋을까
클러스터 개수 K를 정하는 데는 정답이 없습니다. 저희는 **"이 클러스터 정보만으로 영상의 반응을 얼마나 설명할 수 있는가"**를 기준으로 삼았습니다. 클러스터 라벨로 영상의 반응 점수를 예측했을 때의 설명력(R²)을 K별로 비교한 것입니다.
| 클러스터 수 K | R² |
|---|---|
| 10 | 0.187 |
| 25 | 0.192 |
| 50 | 0.222 |
| 100 | 0.203 |
K=50에서 가장 좋았습니다. 눈여겨볼 점은 100에서 다시 떨어졌다는 것입니다. 너무 잘게 쪼개면 클러스터 하나에 영상이 몇 개 남지 않아서, "이 클러스터는 이런 성격이다"라고 말할 근거 자체가 사라집니다. K=50에서 클러스터별 아이템 수는 28~216개 정도로 분포했습니다.
클러스터를 꼭 하나만 줘야 할까
한 발 더 나아가, 영상 하나에 클러스터를 하나만 주는 대신 가장 가까운 Top-3 클러스터를 가중치와 함께 주는 soft assignment를 시도했습니다.
| 배정 방식 | R² |
|---|---|
| 채널 단위 분류 (비교군) | 0.235 |
| Hard assignment (클러스터 1개) | 0.222 |
| Soft top-3 (클러스터 3개 + 가중치) | 0.257 (+16%) |
| Soft top-3 + 채널 단위 분류 | 0.261 |
생각해보면 당연한 결과이기도 합니다. 글 첫머리의 타블로의 팟캐스트 영상만 해도 팟캐스트이면서 동시에 유명인 인터뷰입니다. 팟캐스트를 좋아해서 본 유저도 있고, 타블로가 나와서 본 유저도 있을 텐데, 클러스터를 하나만 고르라고 강요하는 순간 그중 한쪽 정보가 통째로 버려집니다.
표 맨 아래를 보면, soft top-3에 채널 단위 분류를 더해도 0.261로 거의 오르지 않았습니다. 클러스터가 채널 정보를 이미 상당 부분 담고 있다는 뜻입니다. 최종적으로는 512차원 텍스트 벡터에 50차원 클러스터 벡터를 붙인 562차원을 아이템 피처로 사용했습니다.
신규 영상을 클러스터에 배정하기
그 다음으로는 신규 영상 클러스터 배정입니다. 신규 쇼츠는 계속하게 들어오게 되고 많게는 1주일에 1,000개 가량의 영상들이 들어오게 됩니다. 6월 26일 기준 1,649편이던 영상이 8월 23일에는 8,429편이 됐습니다. 두 달 만에 5배가 된 것입니다.
이 동안 클러스터를 그대로 두면, 새로 들어온 주제는 억지로 옛날 클러스터에 끼워 맞춰집니다. 그렇다고 매번 다시 학습할 수도 없습니다. 그래서 재학습 기준을 명시적으로 정해두었습니다.
- 평상시
신규 임베딩을 만들어 기존 centroid와의 코사인 유사도로 배정만 합니다 (hard 1개 + soft top-3). - 재학습 조건
신규 임베딩 1,000개 이상, 그리고 직전 재학습 후 14일 경과. 두 조건을 모두 만족할 때만 실시합니다. - 재학습 후
K 개수 재검토(코사인 실루엣, LOO R², 클러스터별 영상 수 분포) → 정성 평가 → 전체 재배정 후 새 버전 활성화.
그리고 이 판단을 눈으로 할 수 있도록 어드민에 모니터링 페이지를 붙였습니다. 신규 영상 증가량, 평균 centroid 거리 변화, soft assignment 비율 등을 한 화면에서 확인합니다.
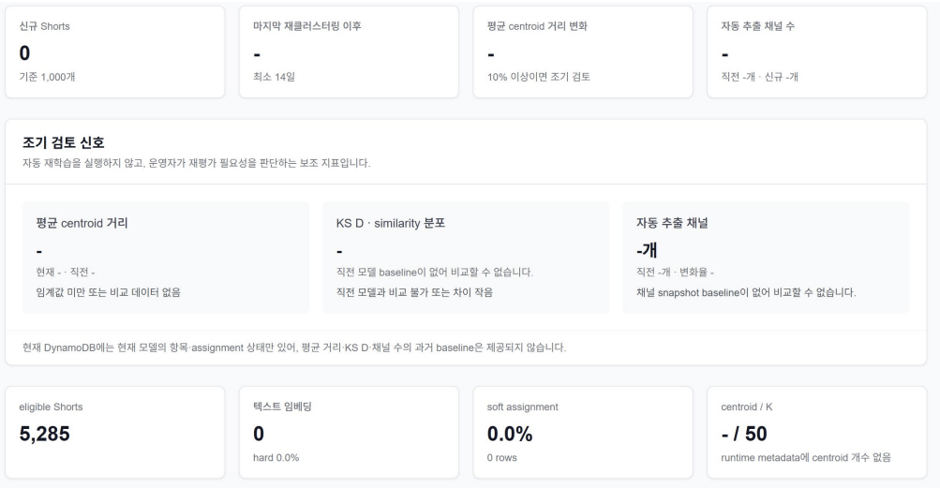
여기에 클러스터별 반응 점수를 함께 얹으니 예상하지 못했던 쓸모가 생겼습니다. 어떤 주제의 영상을 더 확보해야 하는지가 보이기 시작한 것입니다.
- 반응은 좋은데 남은 미노출 영상이 적은 클러스터 → 소싱 우선순위
- 반응은 좋은데 노출이 소수 영상에만 몰린 클러스터 → 로테이션 우선순위
추천 모델에 넣을 피처로 만들었던 클러스터가, 콘텐츠 수급 의사결정 도구가 된 셈입니다.
결론
이번 작업의 핵심은 결국 하나였습니다. "비슷하다"는 말을 사람이 정의하지 않고, 콘텐츠가 스스로 정의하게 만든 것입니다.
채널이나 태그는 사람이 미리 만들어둔 칸이고, 콘텐츠는 그 칸에 잘 들어맞지 않습니다. 임베딩으로 영상을 벡터화하고 방향 기준으로 묶자, 채널 단위 분류보다 설명력이 높은 분류 체계가 만들어졌습니다. 그리고 하나만 고르게 하지 않고 Top-3를 허용하자 설명력이 한 번 더 올라갔습니다.
무엇보다, 추천 피처로 만들었던 클러스터가 콘텐츠 수급 의사결정에도 쓰이게 된 것이 이번 작업에서 가장 기억에 남습니다. 잘 만든 중간 표현 하나는 원래 목적 바깥에서도 쓸모를 찾아간다는 것을 확인했습니다.
소감
8주간의 긴 여정이 끝났습니다. 먼저 저희 그로스해커스 팀에 모든 권한을 열어주시고 최대한 많은 것을 경험할 수 있게 해주신 세타원 직원분들께 감사의 말씀을 드립니다. 덕분에 Supabase와 PostHog처럼 그동안 써볼 기회가 없었던 도구들을 직접 다뤄보며 실무를 많이 배웠습니다.
개인적으로는 여러 사람이 어떻게 협업해서 개발하고, 무엇을 어떻게 공유하며 함께 나아가는지를 조금이나마 알게 된 시간이었습니다. 랭플릭스가 지금보다 더 유명해질 것이라 믿으며, 여기저기 열심히 홍보하도록 하겠습니다!
좋아하는 유튜브·넷플릭스 영상으로 영어를 공부하는 랭플릭스는 지금 앱스토어와 플레이스토어에서 이용하실 수 있습니다.
읽어주셔서 감사합니다!