Two-Tower 모델로 Langflix 추천 시스템 개발하기
안녕하세요! 2026년 7월부터 8월까지 Theta One과 함께 Langflix 추천 시스템 개발에 참여한 여재욱입니다!
저는 Warm User를 대상으로 Two-Tower Model을 활용해 유저의 관심사에 맞는 Shorts를 추천하는 모델을 주로 담당했습니다. 모델을 한 줄로 요약하면, 전체 Shorts를 50개의 Cluster로 분류한 뒤 유저의 시청 기록을 활용해 User와 Item을 각각 같은 Embedding Space에 표현하고, 두 벡터가 얼마나 유사한지를 보는 방식입니다.
쉽게 말하면 유저가 좋아한 영상과는 가깝게, 싫어하거나 선호하지 않은 영상과는 멀게 각각 Embedding한 뒤, 해당 유저와 가까운 위치에 있는 다른 미시청 영상을 찾아 추천하는 방식이죠.
버전 1인 만큼 사용하는 Feature 역시 시청 기록과 영상의 텍스트 정보 정도로 비교적 단순하고, 모델 자체도 Multi-Layer Perceptron 기반의 간결한 구조입니다. 하지만 오늘 글에서는 모델 자체보다는, 그 모델을 만들기 전에 저희 팀이 어떤 문제들을 고민했는지를 중심으로 공유하려고 합니다.
Langflix가 학습 앱으로서 가져야 하는 목적부터, 실제 서비스에서 실시간으로 Serving할 수 있을 정도로 가벼워야 한다는 제약까지 고려해야 할 점이 많았거든요. 가장 Raw한 User의 시청 기록에서 출발해, 저희 팀이 어떤 고민을 거쳐 Feature와 Model을 만들고 최종적으로 User에게 추천을 Serving하기까지의 과정을 순서대로 소개하고자 합니다.
1. Langflix 추천 시스템의 특징
우선 Langflix라는 앱의 목표와 특성을 이해하는 것이 가장 중요했습니다.
Langflix는 넷플릭스나 YouTube Shorts를 통해 영단어와 표현을 공부할 수 있는 영어 학습 앱으로, 단순히 유저가 흥미를 가질 만한 영상을 추천해주는 일반적인 추천 시스템과는 목표가 달랐습니다.
일반적인 YouTube Shorts 추천 시스템이었다면 영상을 하나라도 더 보고, Shorts 탭에 1초라도 더 머물도록 만드는 것이 중요한 목표일 수 있습니다. 하지만 Langflix에서는 단순히 Shorts를 오래 시청하도록 하는 것보다, Shorts 시청이 Langflix 안의 실제 학습 행동으로 자연스럽게 이어지도록 만드는 것이 더 중요했습니다.
프로젝트 전체의 목표는 앱 Retention 향상이었지만, 추천 시스템 안에서는 유저가 Shorts를 통해 학습 기능을 더 많이 활용하도록 만드는 것을 주요 목표로 두었습니다. 이 목표는 이후 구체적인 학습 Signal을 설계하는 과정에도 그대로 반영됩니다.
또 Langflix에서는 무료 유저가 하루에 Shorts를 3개밖에 보지 못했고, 유료 구독이 BM의 핵심을 차지하고 있었습니다. 따라서 무료 유저와 유료 유저에게 제공하는 추천 시스템의 목표도 서로 달라야 했습니다.
무료 유저는 많은 Shorts를 시청할 수 없었고, 대부분이 Cold Start 상태이기 때문에 개인화 추천을 제공하기도 어려웠습니다. 적은 수의 Shorts 노출 안에서도 Langflix의 기능과 학습 경험을 충분히 느끼도록 만드는 것이 중요했죠.
그래서 무료 유저에게는 이미 여러 유저가 반복해서 시청했고, 실제 학습 행동으로 전환되는 비율도 높은 검증된 영상 Pool을 중심으로 추천하기로 했습니다. 여기에 회원가입 과정에서 응답한 온보딩 설문 결과를 함께 활용했습니다.
반면 유료 유저는 상대적으로 많은 행동 로그가 쌓여 있었고, 이를 바탕으로 유저가 꾸준히 흥미를 유지할 수 있도록 취향에 맞는 영상을 개인화해서 추천하는 것이 중요했습니다.
따라서 유저의 행동 로그를 바탕으로 취향을 표현한 뒤, 이에 부합하는 영상을 찾아주는 모델을 구상했습니다. 단순히 인기 있는 영상만 반복해서 보여주는 것이 아니라, 아직 조회수가 낮더라도 영상의 내용을 분석했을 때 해당 유저가 좋아할 가능성이 높다면 적극적으로 추천하는 방식이었죠.
여기서 저희가 발견한 문제는 기존 Shorts 추천 시스템이 Popularity를 주요 기준으로 삼고 있었기 때문에, 이미 반응이 많았던 영상들만 계속해서 추천되고 노출 수가 적거나 전혀 없었던 영상들은 계속해서 추천에서 밀려나고 있었다는 점입니다.
전체 Shorts의 약 60%가 최근 한 달 동안 노출 수가 아예 0인 Cold Item이었습니다. 만약 저희 역시 User의 행동 로그만을 주로 활용하는 전통적인 Collaborative Filtering 방식에 의존했다면, 이 60%의 Shorts는 앞으로도 추천받기 어려웠겠죠.
따라서 저희에게는 User의 취향은 충분히 반영하면서도, 기존 반응 데이터가 없는 Item까지 적절히 추천할 수 있는 모델이 필요했습니다.
마지막으로 추천 시스템은 실제 서비스 환경에서도 작동해야 했습니다.
Langflix의 Shorts 탭은 무한 Scroll 형태로 새로운 영상을 계속 추천해야 했기 때문에 Latency와 Memory에 대한 제약도 꽤 컸습니다. TypeScript 서버에서 빠르고 가볍게 작동해야 했기 때문에 추천 요청이 들어올 때마다 무거운 Python ML Model을 실행하거나, 수천 개의 영상에 복잡한 Deep Learning Model을 반복해서 적용하는 방식은 사용하기 어려웠습니다.
결국 학습 앱이라는 서비스의 목적, Cold Item 문제, 개인화, 실시간 Serving이라는 조건이 이후 추천 모델을 설계하는 과정에 모두 영향을 주었습니다.
2. User 행동 정리하기
유저 취향에 맞는 Shorts를 추천하려면 가장 먼저 User의 어떤 행동을 ‘좋아했다’고 볼 것인지 정해야 합니다.
가장 처음 시도한 것은 User의 여러 행동을 조합해 프로젝트의 북극성 지표인 Retention을 빠르게 대신할 수 있는 Proxy Metric을 만드는 것이었습니다.
Retention은 중요한 지표이지만 추천 모델을 변경한 뒤 결과를 확인하려면 D1, D7까지 며칠을 기다려야 했고, User가 Retention했는지 여부를 추천 모델의 직접적인 학습 Label로 사용하는 것 역시 여러 면에서 부정확했습니다.
따라서 User의 직접적인 행동들이 Retention과 어느 정도 연관관계를 가지는지 분석하고, 그중 상대적으로 중요한 행동과 덜 중요한 행동을 가려내고자 했습니다.
저희는 앱 안에서 User가 할 수 있는 각 학습 관련 행동의 Action Rate를 이용해 D1/D7 Retention 여부를 Logistic Regression으로 예측하는 실험을 진행했습니다.
User별 Action Rate에는 Bayesian Smoothing을 적용했고, Regression Coefficient를 정규화해 각 행동의 Weight처럼 사용하는 방식이었습니다. 초기 결과에서는 50% 이상 시청이 가장 높은 계수를 보였고, 복습, 북마크, 반복 시청 등의 행동도 그보다는 낮지만 유의미한 계수를 보였습니다.
처음 아이디어는 이 Coefficient를 그대로 이용해 하나의 **‘유효 행동 지수’**를 만드는 것이었습니다.
하지만 실제로 Retention이라는 결과 자체가 다양한 변수의 영향을 받고 어느 정도 우연성도 포함하는 만큼, 몇 가지 행동만으로 이를 안정적으로 예측하기는 어려웠습니다. 따라서 Regression Coefficient를 그대로 추천 시스템의 학습 Signal이나 하나의 지수로 사용하는 것은 신뢰도가 낮다고 판단했습니다.
ROC-AUC를 확인하거나 유효 행동 지수와 Retention 사이의 Monotonicity를 확인했을 때도 분명한 한계가 있었습니다.
다만 이 실험은 여러 행동 가운데 어떤 행동이 상대적으로 중요하고 Retention과 더 가까운지 대략적인 방향을 파악하는 데에는 큰 도움을 주었습니다.
결국 구체적인 Coefficient 값을 그대로 활용해 하나의 Proxy Metric을 만드는 대신, Coefficient와 각 행동의 전체 발생 빈도 등을 함께 고려해 유의미한 학습 행동의 범주에 들어갈 행동들을 추리는 정도로 실험을 마무리했습니다.
결과적으로 Proxy Metric을 만드는 데에는 실패했지만, 어떤 행동이 실제 학습과 Retention에 가까운 Signal인지 알아보는 EDA로 남은 셈입니다.
3. 학습 Signal 정의하기
Langflix에는 명시적인 별점과 같은 지표가 존재하지 않았기 때문에, User의 행동을 통해 선호도를 간접적으로 추론해야 했습니다.
다시 말하면 Explicit Feedback을 직접 활용하기는 어려웠고, Implicit Feedback을 이용해 학습 Signal을 정의해야 했던 것이죠.
최종적으로 유의미한 학습 행동으로 분류한 것은 복습, 섀도잉, 리스닝, 표현 저장까지 총 네 가지였습니다.
이후에는 각 행동의 긍정/부정 여부와 강도만을 유지하여 Interaction을 대략 다음과 같이 점수화했습니다.
+2: Shorts 안에서 학습 관련 행동 발생+1: 영상의 절반 이상 또는 20초 이상 시청-1: 5초 이하로 시청하고 Skip-2: ‘관심 없음’ 클릭0: 위 행동에 해당하지 않음
즉,
학습 행동 > 몰입 시청 > 일반 반응 > 빠른 Skip > 명시적인 거절
순서로 선호의 강도를 표현했습니다.
User가 과거 어떤 Shorts를 시청한 뒤 실제 학습 행동까지 수행했다면, 해당 영상에 강한 긍정 반응을 남겼다고 판단해 +2점을 부여했습니다.
학습 행동까지 이어지지는 않았더라도 영상을 절반 이상 또는 20초 이상 시청했다면, 최소한 영상의 주제나 내용에 어느 정도 관심이 있었다고 보고 약한 긍정 반응인 +1점을 부여했습니다.
반대로 영상이 노출된 뒤 5초 이내에 바로 Skip했다면 해당 Shorts의 내용이나 주제가 User 취향과 잘 맞지 않았다고 판단해 약한 부정 반응인 -1점을 부여했습니다. ‘관심 없음’처럼 User가 직접 거절 의사를 표시한 경우에는 그보다 강한 Negative Signal인 -2점을 주었습니다.
이렇게 User가 과거 각 Item에 보인 반응을 하나의 Score로 변환해 User-Item Interaction Matrix를 만들었고, 이 Interaction 정보가 이후 User Feature를 만드는 가장 중요한 기반으로 사용됩니다.
4. Two-Tower 모델 만들기
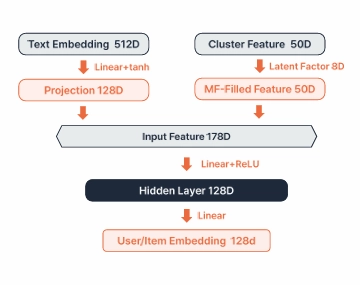
저희가 선택한 추천 시스템 모델은 Two-Tower Model입니다. 사용할 수 있는 Feature가 Shorts의 텍스트 정보와 User의 활동 이력 정도였기 때문에, 두 정보를 모두 활용할 수 있는 CF와 CBF의 Hybrid 형태를 원했습니다.
처음부터 Two-Tower만을 고려했던 것은 아닙니다. User와 Item의 Interaction만 활용하는 Collaborative Filtering은 충분한 행동 데이터가 있는 Item에는 효과적이지만, 앞서 언급했듯 당시에는 Cold Item의 비율이 상당히 높았습니다. Interaction이 없는 신규 Item까지 추천하려면 콘텐츠 자체의 정보도 함께 활용할 필요가 있었습니다.
Graph 기반 모델 역시 User별 Interaction 수가 적어 Graph 자체가 지나치게 Sparse하다고 판단했고, Sequence 기반 모델은 하루나 한 Session에서 시청하는 Shorts 수가 많지 않아 직전 시청 순서보다 누적된 취향을 먼저 표현하는 것이 중요하다고 생각했습니다.
반면 Two-Tower는 User의 행동 정보와 Item의 콘텐츠 정보를 각각 Feature로 사용하면서, 두 정보를 같은 Embedding Space 위에 표현할 수 있었습니다. 특히 Item의 ID 자체를 학습하는 것이 아니라 Item Feature를 Embedding으로 변환하는 함수를 학습하기 때문에, 시청 기록이 없는 신규 Shorts도 텍스트와 Cluster 정보만 있다면 기존 Item들과 같은 공간에 배치할 수 있었습니다.
또 하나의 중요한 장점은 Item Embedding을 미리 계산할 수 있다는 점입니다.
학습 단계에서 모든 Item Feature를 Item Tower에 넣어 128차원의 Item Embedding으로 변환해 저장해두면, 실제 추천 시에는 User Feature만 새로 계산해 User Tower를 한 번 통과시킨 뒤 기존 Item Embedding들과 Dot Product를 계산하면 됩니다.
즉 무거운 계산은 미리 수행하고, 실제 Serving에서는 User Vector 하나와 이미 계산된 Item Vector들을 비교하는 구조로 만들 수 있었습니다. 실시간으로 빠르게 다음 Shorts를 반환해야 하는 Langflix의 환경과 잘 맞는 방식이었죠.
초기 버전인 만큼 Feature 역시 최대한 단순하게 가져갔습니다.
Item Feature는 Item Cluster Assignment와 Item Text Semantic Vector를 사용했고, User Feature는 User-Cluster Interaction Vector와 최근 시청 영상들의 Text Semantic Vector를 사용했습니다.
이 Feature들을 각각 User Tower와 Item Tower의 MLP에 넣어 공통된 128차원의 Embedding Space로 변환했습니다.
처음부터 Channel, 난이도, Sequence 등 가능한 모든 Feature를 넣기보다는, 왜 필요한지 설명할 수 있는 Feature부터 사용하고 이후 실험을 통해 확장할 수 있는 구조로 만들고자 했습니다.
5. Item Feature 만들기(난이도 포함)
Item Feature에는 각 아이템이 어떠한 주제를 담고 있고, 어떤 내용으로 구성되어 있는지를 담았습니다.
사용 가능한 정보 중 가장 안정적으로 확보할 수 있었던 것은 Shorts의 텍스트 정보였습니다. 이미지나 음성도 사용할 수 있었지만, Feature 추출 비용이나 시스템 복잡도를 고려해 초기 버전에서는 제외했습니다.
초기 실험에서는 자막을 중심으로 여러 Embedding Model을 비교했고, 최종 구현에서는 제목, 자막, 시놉시스의 세 텍스트 필드를 함께 사용했습니다.
각 필드는 OpenAI의 text-embedding-3-small 모델을 이용해 512차원의 벡터로 변환했습니다. 이후 제목, 자막, 시놉시스의 역할이 서로 다르다고 보아 각각 0.4 / 0.5 / 0.1의 비율로 가중 결합했습니다.
제목은 영상의 핵심 주제나 인물을 짧게 요약하고 있고, 자막은 실제 영상에서 어떤 이야기가 이루어지는지를 가장 직접적으로 보여줍니다. 시놉시스는 추가적인 설명을 제공하지만 SNS 링크나 홍보 문구 등 Noise가 상대적으로 많이 포함되어 있어 보조적으로만 활용했습니다.
이렇게 만들어진 512차원의 Semantic Vector는 평균 중심화와 L2 Normalization을 거친 뒤 Spherical K-Means를 이용해 약 50개의 Cluster로 나누었습니다.
처음에는 한 영상이 하나의 Cluster에만 속하도록 One-Hot Vector 형태의 Hard Assignment를 사용할 생각이었습니다. 하지만 실제 콘텐츠는 하나의 주제로만 설명되지 않는 경우가 많았습니다.
예를 들어 연예인의 인터뷰 영상이면서 동시에 연애나 자기계발 이야기를 할 수도 있습니다.
그래서 가장 가까운 최대 3개의 Cluster를 함께 반영하는 Soft Assignment 방식을 사용했습니다. 각 Cluster까지의 유사도를 기반으로 Weight를 부여하고, 전체 합이 1이 되도록 만들어 50차원의 Cluster Feature로 표현했습니다.
최종 Item Feature는 따라서
512차원 Text Semantic Vector + 50차원 Cluster Vector
로 구성된 562차원의 Feature가 되었습니다.
난이도는 취향과 조금 다르게 다뤘습니다
처음부터 가지고 있던 가설 중 하나는 영상의 주제만큼이나 난이도가 중요할 것이라는 점이었습니다.
만약 단순히 보고 싶은 Shorts가 있다면 유튜브에서 볼 수도 있습니다. 굳이 Langflix를 이용한다는 것은 어느 정도 영어를 공부하려는 목적이 있다고 생각했습니다.
그렇다면 완벽하게 취향인 영상을 찾는 것만큼이나 현재 이 유저가 학습하기 적당한 영상을 보여주는 것도 중요할 수 있습니다.
난이도는 최종적으로 크게 세 축으로 정리했습니다.
- 영상에 등장하는 어휘의 CEFR 난이도
- 평균적인 단어 길이
- 자막 Timing을 이용한 발화 속도
각 지표를 정규화해 세 개의 난이도 축으로 만들고, 이를 다시 하나의 difficulty_score와 5단계 Bucket으로 변환했습니다.
처음에는 이 난이도 값 역시 Two-Tower의 Feature 안에 넣는 방법을 고려했습니다. 하지만 난이도는 취향과는 조금 다른 성격이라고 판단했습니다.
축구와 뉴스를 얼마나 좋아하는지는 연속적인 선호의 문제이지만, Beginner User에게 가장 어려운 난이도의 영상을 보여주지 않는 것은 취향보다는 Constraint에 더 가깝습니다.
그래서 난이도는 Tower 내부에서 학습시키지 않고, 이후 Candidate를 만들 때 User의 온보딩 영어 레벨과 비교해 지나치게 쉽거나 어려운 영상을 미리 제거하는 사전 필터링 Feature로 활용했습니다.
6. User Feature 만들기(MF 포함)
Two-Tower 모델에서 Item Feature와 의미상 대칭을 이루도록 User 역시 같은 두 가지 방향으로 표현했습니다.
첫 번째는 최근에 어떤 내용의 영상을 좋아했는지를 표현하는 Text Semantic Vector입니다.
유저가 최근 시청한 최대 30개 Shorts의 512차원 Text Embedding을 가져와 가중평균하여 User Text Profile을 만들었습니다.
단순한 평균 대신 앞서 정의한 Interaction Score를 Weight로 사용했습니다. +2점 반응을 보인 영상은 User의 취향 방향으로 강하게 반영하고, 빠르게 Skip한 영상은 반대 방향으로 반영하는 식입니다.
여기에 시간 감쇠를 추가했습니다.
최근에 본 영상일수록 현재의 관심사를 더 잘 반영한다고 보고, i번째 과거 영상에는 대략 exp(-0.05i) 형태의 Weight를 곱했습니다.
즉 최근에 강한 긍정 반응을 보인 영상이 User Text Profile에 가장 크게 반영되고, 오래전에 본 영상의 영향은 조금씩 줄어드는 구조입니다.
시청 기록이 지나치게 적은 User는 몇 개 영상만으로 User Vector의 방향이 크게 결정될 수 있기 때문에, History 수가 적을수록 Profile의 영향을 줄이는 Scaling도 함께 적용했습니다.
두 번째 Feature는 각 콘텐츠 Cluster에 대해 User가 어떤 반응을 보였는가입니다.
처음에는 약 5천 개 Item 각각에 대한 User-Item Interaction Matrix를 생각했지만 대부분의 User가 실제로 본 영상은 30개도 되지 않았기 때문에 Matrix가 거의 비어 있었습니다.
이를 줄이기 위해 Item을 앞에서 만든 50개 Cluster 단위로 묶고, 같은 Cluster에 속한 영상들의 Interaction Score를 합산하여 User-Cluster Interaction Matrix를 만들었습니다.
예를 들어 User가 Cluster 3의 영상들에
+1, +1, 0, +2, +1, -1
의 반응을 보였다면 이를 합산하고 일정 범위 안으로 조정해 해당 Cluster에 대한 선호도를 표현했습니다.
하지만 5천 개 Item을 50개의 Cluster로 줄인 뒤에도 한 User가 모든 Cluster를 경험하는 것은 아니었기 때문에 여전히 빈칸이 존재했습니다.
이를 보완하기 위해 Matrix Factorization을 적용했습니다.
User-Cluster Matrix를
- 전체 평균
- User Bias
- Cluster Bias
- User Latent Factor
- Cluster Latent Factor
로 분해하고, 실제 관측된 Interaction을 잘 복원하도록 학습했습니다.
최종 구현에서는 8차원의 Latent Factor를 사용하고 MSE Loss를 통해 학습했습니다.
이렇게 학습한 값을 다시 조합하면 User가 한 번도 보지 않은 Cluster에 대해서도
“다른 Cluster에 대한 이 User의 반응과 다른 User들의 행동을 보면 이 정도로 좋아할 것 같다.”
는 값을 대략적으로 채울 수 있습니다.
결과적으로 최종 User Feature는
- 최근 시청 영상으로 만든 512차원 Text Profile
- MF로 Sparsity를 보완한 50차원 Cluster Interaction
두 정보를 함께 사용했습니다.
앞에서 만든 Item Feature와 마찬가지로 하나는 영상의 세부적인 Semantic 취향을, 다른 하나는 콘텐츠의 큰 주제에 대한 선호를 표현하도록 구성한 셈입니다.
7. Loss 함수 설계
User와 Item Feature까지 만들었다면 이제 두 Embedding을 어떤 기준으로 배치할지 정해야 합니다.
저희는 주된 Loss로 BPR, Bayesian Personalized Ranking을 사용했습니다.
추천 시스템에서는 특정 Item의 절대적인 점수를 정확하게 맞히는 것보다, User가 A 영상을 B 영상보다 선호했다면 모델 역시 A에 더 높은 Score를 주는 것이 중요하다고 판단했기 때문입니다.
따라서 User가 높은 Interaction Score를 남긴 영상은 User와 더 가까이, 낮은 Score를 남긴 영상은 상대적으로 멀리 배치되도록 Pair 단위로 학습했습니다. BPR은 상대적인 순서를 중심으로 학습하기 때문에, Interaction Score와 모델의 유사도 값 자체에도 어느 정도 관계가 생기도록 Smooth L1 Loss도 보조적으로 함께 사용했습니다.
여기서 Loss 함수 자체보다 더 고민했던 부분은 Negative Sampling이었습니다.
User가 보지 않은 영상은 싫어한 영상이 아니라 단순히 기존 추천 시스템에서 한 번도 노출되지 않았던 영상일 수도 있습니다. 특히 Cold Item이 많은 상황에서 모든 Unseen Item을 Negative처럼 학습한다면, 기존에 추천받지 못한 Item은 새로운 모델에서도 계속 추천받기 어려워집니다.
그래서 실제 빠른 Skip처럼 관측된 Negative와 단순히 시청하지 않은 Unseen Item을 구분했습니다. Unseen Item도 일부 학습에는 사용했지만 일반적인 Negative보다 훨씬 작은 Weight를 주었고, Negative Sample의 개수 역시 Positive에 비해 지나치게 많아지지 않도록 제한했습니다.
Positive Interaction 없이 Negative 기록만 있는 User는 BPR 학습에서 제외했고, 활동량이 많은 일부 User가 전체 Loss를 지나치게 많이 차지하지 않도록 User별 Loss 기여도도 조정했습니다.
이 과정에서 모델 구조만큼이나 어떤 행동을 Positive와 Negative로 정의하고, 어떤 Pair를 학습에 사용하는지가 추천 결과에 큰 영향을 미친다는 것을 알 수 있었습니다.
8. 최종 추천 Ranking 구현
Two-Tower가 User와 Item의 유사도를 계산한다고 해서 단순히 Score가 높은 10개 영상을 그대로 추천하지는 않았습니다.
먼저 최근에 이미 시청하거나 노출된 영상, 추천에서 제외된 콘텐츠, 차단된 Channel, User의 영어 수준에 비해 지나치게 쉽거나 어려운 영상 등을 Candidate 단계에서 미리 제거했습니다.
이후 User Embedding과 Item Embedding의 Dot Product를 계산해 Two-Tower Score가 높은 Top-100 영상을 개인화 Candidate로 가져왔습니다.
Two-Tower만 사용하는 대신 Popularity Candidate도 함께 사용했습니다. Two-Tower는 개인 취향을 잘 반영하지만 아직 충분히 검증되지 않은 콘텐츠까지 높은 순위에 올릴 수 있고, 반대로 Popularity는 전체적으로 좋은 반응을 얻은 콘텐츠를 안정적으로 추천할 수 있기 때문입니다.
Popularity 역시 단순 조회 수보다는 최근 30일 동안 실제 학습 행동이 많이 발생한 영상을 기준으로 만들었고, User 취향과 지나치게 동떨어진 영상이 들어오는 것을 막기 위해 일정 수준 이상의 Two-Tower Score를 가진 Item만 사용했습니다.
마지막에는 비슷한 영상이 연속으로 추천되는 문제를 줄이기 위해 MMR을 적용했습니다.
MMR은 User와의 관련성이 높은 영상을 우선적으로 선택하되, 이미 Feed에 들어간 영상과 너무 비슷한 Item은 감점하는 방식입니다. 영상 간 유사도에는 앞에서 만든 Text Embedding을 활용했고, 같은 Cluster의 Item이 지나치게 많이 들어가지 않도록 노출 개수에도 제한을 두었습니다.
또 Two-Tower와 Popularity 양쪽에서 계속 선택되지 않는 Item도 새로운 Interaction을 얻을 수 있도록, 일부 Slot에는 Epsilon-Greedy 방식의 Exploration을 적용했습니다.
결국 최종 Feed는 Candidate Filtering, Two-Tower와 Popularity Retrieval, MMR Re-Ranking, Exploration을 순서대로 거쳐 만들어졌습니다.
9. 오프라인 평가 방법
모델을 만들고 가장 고민했던 문제 중 하나는 어떤 모델을 좋은 모델이라고 평가할 것인가였습니다.
일반적인 추천 시스템에서는 Recall@K나 nDCG@K를 많이 사용합니다. 하지만 Langflix의 과거 Interaction Data 자체가 기존 Popularity 중심 추천 시스템에 의해 만들어졌다는 문제가 있었습니다.
기존 모델이 인기 영상만 많이 보여줬다면 Test Data에도 인기 영상이 많이 존재합니다. 따라서 기존 Popularity 추천과 비슷한 영상을 추천할수록 Recall은 높아지고, 반대로 기존에 노출되지 않았던 Cold Item을 적극적으로 추천하면 오히려 점수가 떨어질 수도 있었습니다.
하지만 Two-Tower를 만든 이유 중 하나는 바로 이런 Cold Item도 User 취향에 맞게 찾아내는 것이었습니다. 그래서 Recall이나 nDCG 하나만으로 모델을 선택하지 않고, 저희가 해결하려는 문제에 맞춰 네 가지 Offline Metric을 별도로 사용했습니다.
첫 번째는 Embedding Effective Rank입니다. Two-Tower의 Output은 128차원이지만, 실제 Embedding이 몇 개의 방향에만 몰려 있다면 높은 차원을 사용하는 의미가 없습니다. 따라서 User와 Item Embedding이 실제로 충분히 다양한 방향으로 퍼져 있는지를 확인했습니다. 최종 모델에서는 User Embedding이 12.06, Item Embedding이 25.03 정도의 Effective Rank를 보였습니다.
두 번째는 Cold Coverage@5입니다. 모든 평가 User에게 5개씩 추천했을 때, 전체 Cold Item 가운데 최소 한 번이라도 추천된 Item의 비율을 계산했습니다. 학습 기간 기준 전체 Item의 약 58.8%가 Cold Item이었고, 최종 모델의 Cold Coverage@5는 12.02%였습니다.
세 번째는 Ordinal Accuracy입니다. Test에 실제 등장한 Item 두 개를 Pair로 만들고, 실제 Interaction Score가 더 높은 Item에 Two-Tower 역시 더 높은 Score를 주는지 확인했습니다. 최종 모델의 Ordinal Pair Accuracy는 0.644로, 약 64.4%의 Pair에서 실제 선호 순서를 올바르게 예측했습니다.
마지막은 Cold Recall@5입니다. Train 기간에는 Cold였지만 Test 기간에는 실제 User가 긍정적인 반응을 보인 Item을 따로 모은 뒤, 모델이 Interaction이 없던 시점에도 해당 Item을 미리 추천할 수 있었는지를 측정했습니다. 7일 Test 기준 Cold Recall@5는 3.65%였습니다.
결국 Effective Rank는 Embedding 자체가 망가지지 않았는지, Cold Coverage는 기존에 버려지던 Item을 충분히 탐색하는지, Ordinal Accuracy는 User의 상대적인 선호를 잘 학습했는지, Cold Recall은 Cold 상태에서도 앞으로 좋은 반응을 얻을 Item을 찾을 수 있는지를 각각 확인하기 위한 지표였습니다.
이 과정을 통해 추천 시스템에서는 모델을 만드는 것뿐 아니라, 서비스의 목표와 데이터가 만들어진 방식에 맞는 평가 기준을 만드는 것 역시 중요하다는 것을 느꼈습니다.
10. 실제 서빙과 데이터베이스 저장
Python에서 모델이 잘 돌아간다고 실제 서비스에서 바로 사용할 수 있는 것은 아니었습니다.
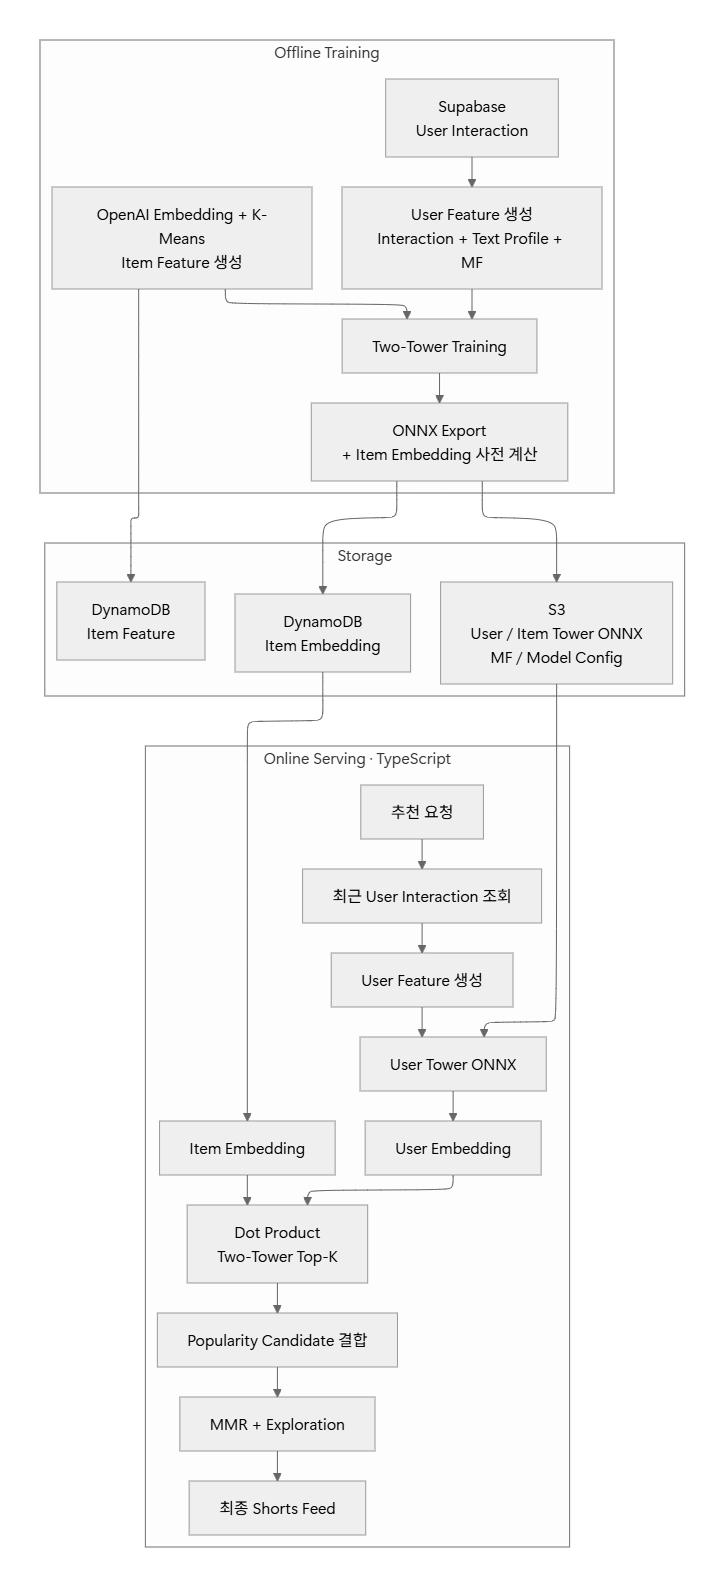
Langflix의 추천 요청은 TypeScript 서버에서 처리되고 있었기 때문에, 모델의 Training과 Serving 과정을 분리했습니다.
Training 단계에서는 일정한 주기로 User Interaction을 가져와 MF와 Two-Tower를 학습하고, User Tower와 Item Tower를 ONNX 형태로 Export했습니다. 모든 Item Embedding 역시 미리 계산해 저장했습니다.
새로운 Shorts가 추가되는 경우에는 전체 모델을 다시 학습할 필요가 없었습니다.
Text Embedding을 만들고 Cluster Assignment를 생성한 뒤 Item Feature를 조립하고, 기존 Item Tower에 한 번 Forward하면 새로운 Item Embedding을 만들 수 있었습니다. 행동 데이터가 없는 신규 Item도 콘텐츠 정보만 있다면 바로 추천 후보로 사용할 수 있는 구조였습니다.
실제 Serving에서는 User의 최신 Interaction을 가져와 User Feature를 만든 뒤 User Tower를 한 번 Forward하고, 미리 저장된 Item Embedding들과 Dot Product를 계산했습니다.
이후 Two-Tower와 Popularity Candidate를 만들고 MMR을 적용해 최종 추천 결과를 반환했습니다.
일반적인 P99 수준 User를 기준으로 전체 추천 과정은 약 59에서 79ms 수준으로 예상되어, 처음부터 중요하게 생각했던 실시간 Serving 조건도 만족할 수 있었습니다.
저장소 역시 데이터의 역할에 따라 분리했습니다.
Supabase에는 User Interaction과 원천 콘텐츠 데이터를 두고, DynamoDB에는 Item Feature와 Item Embedding처럼 Serving 중 빠르게 접근해야 하는 데이터를 저장했습니다. S3에는 ONNX, MF State, Model Config와 같은 Model Artifact를 저장했습니다.
또 Text Embedding, Cluster Centroid, Item Embedding, Tower가 서로 다른 버전을 바라보는 문제를 막기 위해 Version 정보도 함께 관리했습니다.
새로운 Artifact가 모두 정상적으로 생성되고 검증된 뒤에만 새 모델을 활성화하고, 문제가 발생하면 기존에 사용하던 정상 버전을 유지하도록 구성했습니다.
이 과정을 거치면서 추천 시스템은 단순히 Model 하나를 만드는 것이 아니라 Raw Data, Feature, Training, Artifact 저장, 신규 Item 처리, Online Serving까지 전체 Pipeline을 연결해야 완성된다는 것을 체감했습니다.
11. 하이퍼 파라미터 튜닝과 실험
첫 Two-Tower가 동작한 이후에는 새로운 구조를 계속 추가하기보다, 현재 모델이 왜 이상한 추천을 내놓는지를 확인하면서 하나씩 수정하는 작업에 많은 시간을 사용했습니다.
가장 먼저 발견한 문제 중 하나는 Item Embedding들이 서로 비슷한 방향에 몰리는 현상이었습니다.
초기에는 Activation Function으로 ReLU를 사용했지만, 음수 영역이 모두 제거되면서 Embedding이 한쪽 방향으로 몰리는 데 영향을 줄 수 있다고 판단했습니다. 이를 tanh로 변경한 뒤 Effective Rank와 실제 Embedding 분포를 함께 확인했습니다.
Embedding 평균을 원점에 가깝게 만들기 위한 Centering Regularization도 실험했지만, 지나치게 강한 제약은 오히려 개인화 Ranking 학습을 방해할 수 있어 최종적으로는 제외했습니다.
Epoch 역시 많다고 항상 좋은 것은 아니었습니다. Sparse한 Interaction을 반복적으로 학습할수록 일부 데이터에 Overfitting되는 현상이 나타났고, 초기보다 학습 Update 수를 크게 줄이는 방향으로 조정했습니다.
MF의 Latent Rank 역시 여러 값을 실험한 뒤 16에서 8로 줄였고, Negative Sample이 User Vector에 지나치게 큰 영향을 주는 문제를 줄이기 위해 빠른 Skip의 강도나 Negative Sample의 수 역시 조정했습니다.
Cold Item이 Embedding Space에서 한쪽에 뭉치는 문제를 해결하기 위해, Content가 비슷한 Warm Item 주변에 Cold Item을 배치하는 방법도 실험했습니다. 다만 최종적으로는 Two-Tower 자체의 Content Feature와 Negative Sampling, Exploration을 개선하는 방향을 우선했습니다.
또 학습 행동과 일반 시청 행동을 서로 다른 User Representation으로 분리하는 Multi-Behavior 구조도 실험했습니다. 아이디어 자체는 자연스러웠지만 당시 데이터에서는 기존 Single Representation보다 일관된 개선을 확인하지 못해 최종 모델에서는 제외했습니다.
프로젝트를 시작할 때는 Feature나 Layer를 계속 추가하면 자연스럽게 모델이 좋아질 것이라고 생각했습니다.
하지만 실제로는 Activation을 바꾸고, Epoch를 줄이고, MF Dimension을 줄이고, Negative Sample을 제한하고, 효과가 불분명한 구조를 제외하는 식으로 모델을 단순하게 만드는 결정이 더 좋은 결과를 만들기도 했습니다.
결국 최종 모델은 가장 복잡한 구조가 아니라, 각 Feature와 Loss를 왜 사용하는지 설명할 수 있고 실제 Serving까지 연결할 수 있는 비교적 작은 Two-Tower Model로 정리되었습니다.
12. 아쉬웠던 점과 다음에 해보고 싶은 것
이번 프로젝트에서는 제한된 기간 안에 실제 서비스에서 사용할 수 있는 추천 시스템의 첫 버전을 만드는 데 집중했습니다.
Interaction 정의부터 Feature Engineering, Two-Tower Training, Offline Evaluation, 실제 Serving까지 전체 과정을 경험할 수 있었지만 충분히 실험하지 못한 부분도 있었습니다.
먼저 현재 모델은 한 User를 하나의 Embedding으로 표현합니다. 하지만 실제 User의 관심사는 여러 방향으로 나뉠 수 있기 때문에, 여러 개의 User Embedding을 만드는 Multi-Interest 구조나 학습 행동과 일반 시청 행동을 분리하는 Multi-Behavior 구조를 더 실험해보고 싶었습니다. 일부 실험은 진행했지만 당시 데이터에서는 기존 구조보다 안정적인 개선을 확인하지 못해 최종 모델에는 포함하지 않았습니다.
또 이번 버전에서는 MMR의 다양성 비중이나 난이도 Filtering Rule을 대부분의 User에게 동일하게 적용했습니다. 충분한 데이터가 쌓인다면 특정 주제를 집중해서 보는 User와 여러 주제를 폭넓게 보는 User에 따라 MMR Weight를 다르게 하거나, 실제 학습 행동을 기준으로 User마다 적정 난이도를 개인화하는 방식도 시도해볼 수 있을 것 같습니다.
프로젝트 초반에 시도했던 Proxy Metric도 더 많은 데이터가 있다면 다른 방식으로 발전시킬 수 있을 것 같습니다. 하나의 Interaction Score를 직접 만드는 대신 충분한 시청, 표현 저장, 복습, 쉐도잉과 같은 행동별 발생 확률을 각각 예측하고, 이를 Langflix가 중요하게 생각하는 학습 가치에 따라 결합하는 방법도 고려할 수 있습니다.
마지막으로 가장 아쉬웠던 점은 Two-Tower 모델을 충분한 기간 동안 Online A/B Test하지 못했다는 것입니다.
이번에는 기존 Popularity 추천의 Bias를 고려해 Cold Coverage, Cold Recall, Ordinal Accuracy와 같은 Offline Metric을 따로 만들었지만, 결국 좋은 추천인지는 실제 User의 학습 행동이나 Retention을 통해 확인해야 합니다.
다음 버전을 만든다면 단순히 Offline Score가 높은 모델을 만드는 데서 끝내지 않고,
Offline Evaluation → Exploration → Online Experiment → 새로운 Interaction Data → Retraining
으로 이어지는 Feedback Loop 자체를 완성해보고 싶습니다.
결국 이번 버전에서 만든 것은 하나의 완성된 Recommendation Algorithm이라기보다, Langflix에서 어떤 Signal을 보고, User와 Item을 어떻게 표현하고, 어떻게 학습하고, 무엇으로 평가하며, 실제 서비스에 어떻게 연결할지를 정리한 첫 번째 End-to-End 구조에 가까웠다고 생각합니다.
13. 결과 및 소감
추천 시스템 모델을 거의 처음부터 팀원들과 함께 설계해서, 최종적으로 실제 production code에서 돌아가는 형태까지 구현하기 위해 정말 많은 고민이 있었습니다. 더 좋은 추천 시스템을 만들기 위한 일반적인 고민들에 더해, Langflix의 앱 목표와 특성을 고려하고 실제 운영 환경에서 정상적으로 돌아갈 수 있는 추천 시스템을 만드는 것을 위해 많은 논의 과정과 자료 조사, 그리고 AI를 활용한 셀프 학습의 시간을 거쳤습니다.
결과적으로 프로젝트 막바지에 진행한 A/B Test에서는 저희가 만든 추천 시스템을 적용한 Treatment 그룹이 기존 추천 시스템을 사용한 Control 그룹보다 영상당 유효 학습률에서 전반적으로 조금 더 높은 양상을 보였습니다. 실험 기간과 표본이 충분하지 않아 통계적으로 유의미하다고 볼 수는 없지만, 그래도 실제 서비스에 배포된 추천 시스템에서 저희가 목표로 두었던 학습 행동 지표가 적어도 나빠지지 않고 개선 방향을 보였다는 점과 이후 더 긴 온라인 실험을 진행할 수 있는 구조까지 만들어냈다는 점은 의미 있는 결과라고 생각합니다.
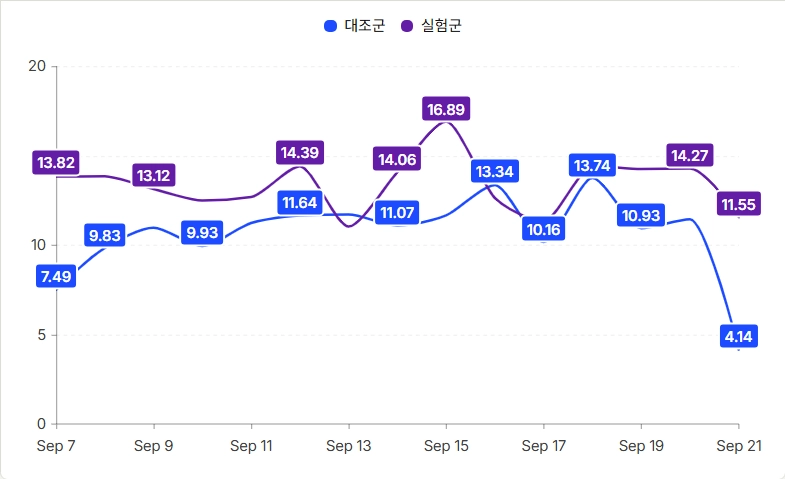
또 추천 품질뿐 아니라 빠른 이탈과 같은 Guardrail 지표도 함께 확인하면서, 개인화 추천이 User Experience를 악화시키고 있지는 않은지도 지속적으로 확인했습니다.
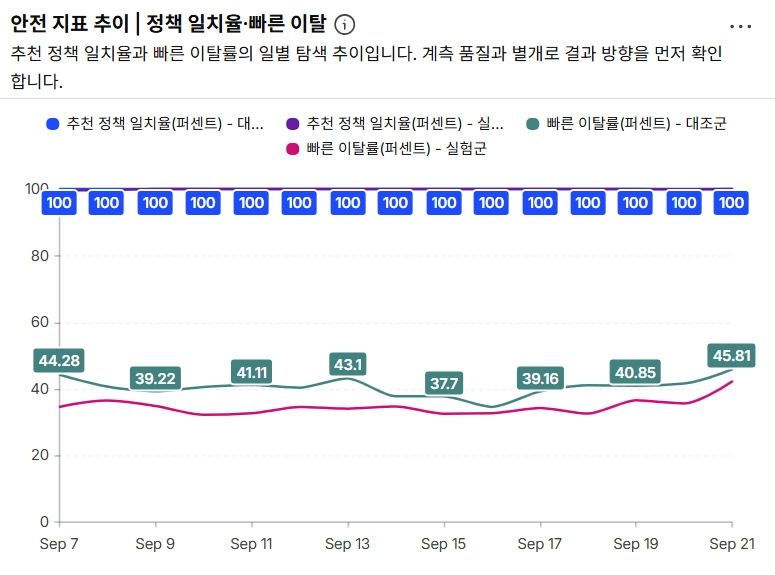
이번 모델은 복잡한 구조 자체를 목표로 하기보다는 Langflix의 데이터 상황과 서비스 목적, 그리고 실제 Serving 환경에 맞는 첫 번째 추천 시스템을 만드는 데 초점을 맞췄습니다. 그 과정에서 Offline Model을 만드는 데서 끝나지 않고 실제 서비스에 연결해 User 반응까지 확인할 수 있었다는 점이 가장 의미 있는 결과였다고 생각합니다.
제 개인적인 소감을 말해보자면, 머신러닝 모델링뿐 아니라 모델을 실제 서비스에 연결하기 위해 필요한 개발 과정을 함께 경험할 수 있었다는 점이 가장 좋았습니다.
특히 AI Agent를 적극적으로 활용하면서 이전에는 익숙하지 않았던 TypeScript 코드베이스를 빠르게 이해하고, 필요한 구조와 라이브러리를 학습해 실제 추천 Serving 코드까지 구현해볼 수 있었습니다. 단순히 코드를 생성하는 데 사용하는 것보다, 새로운 기술을 빠르게 학습하고 구현한 결과를 직접 확인하고 수정하는 과정에서 AI를 개발 도구로 활용하는 방법을 많이 배울 수 있었습니다.
또 GitHub를 통한 Branch, Commit, PR 기반의 협업부터 PostHog를 이용한 실험, Supabase의 User Log 활용, 학습 Artifact의 저장 구조 설계까지 직접 경험했습니다. 여기에 S3와 DynamoDB에 실제 Model과 Feature를 적재하고, ECS Task Role을 통해 서비스 코드와 연결하면서 하나의 ML Model이 실제 Production 환경에서 동작하기까지 필요한 과정도 처음부터 끝까지 경험할 수 있었습니다.
Growth Hackers와 Theta One이 함께한 이번 프로젝트를 통해 저희가 많은 것을 경험하고 성장할 수 있었듯이, 저희가 기여한 이 모델과 결과물들이 앞으로 Theta One의 Langflix 서비스가 더 많은 유저들에게 사랑받고 더욱 성장하는 데 큰 도움이 되기를 바랍니다. 앞으로 Theta One의 미래를 응원하겠습니다!